Ich möchte meinem Computer sagen, was er tun soll.
Ich möchte „tue das“ sagen können und mein Computer tut es. Er soll sehen, was ich sehe, und verstehen, woran ich gerade arbeite, ohne dass ich ihm Fenster, Auswahl und Aufgabe noch einmal erklären muss. Darauf arbeite ich mit pi-os hin. Es geht darum, wie wir mit Computern interagieren, und nicht darum, noch ein Chatfenster auf dem Desktop unterzubringen.
Die Datei ist ausgewählt, der Text steht auf dem Bildschirm. Trotzdem suche ich das passende Menü oder kopiere alles in einen Chat, damit ein Agent die Aufgabe versteht. Ich möchte nicht mehr das, was ich meine, in Klicks und Erklärungen übersetzen müssen. Der Computer soll erkennen, worauf ich mich beziehe, und damit arbeiten.
Deshalb verbindet pi-os automatische Kontexterkennung mit Kommando-Mappings und einem pi-Agenten. Für Befehle wie Löschen oder Erstellen habe ich direkte Zuordnungen eingebaut, damit ein Modell eine bekannte Aktion nicht jedes Mal neu interpretieren muss. Braucht die Aufgabe dagegen Schlussfolgerungen, soll der Agent den bereits sichtbaren Kontext nutzen. Das Ziel ist, die Anweisung einmal zu geben und den Computer den Weg zur Ausführung wählen zu lassen. Für Löschen und andere gefährliche Shell-Befehle habe ich meinen dcg-Fork mit nativem Freigabedialog gebaut.
Das aktive Fenster und die Auswahl sollen dem Computer automatisch zeigen, worum es geht. Ich möchte mich auf „das hier“ beziehen können, ohne erst ein Kontextpaket zusammenzustellen. Was beim Agenten ankommt, muss dabei sichtbar und unter meiner Kontrolle bleiben.
02
Sagen, was passieren soll
„Lösch das.“ „Erstell hier eine Datei.“ Solche Anweisungen möchte ich direkt geben können, während ich bei meiner Arbeit bleibe. Aktion und Ziel zu erkennen soll die Aufgabe des Computers sein, statt für mich wieder eine Folge von Menüs zu bedeuten.
03
Ein Modell nutzen, wenn es nötig ist
Ich habe die Kommando-Mappings eingebaut, weil eine LLM über einen bekannten Befehl nicht erst nachdenken muss. Direkt ausführen reicht. Braucht die Aufgabe Interpretation oder mehrere Schritte, kommt der Agent dazu. Mir geht es darum, dass die Aktion erledigt wird, nicht darum, dass jede Aktion KI nutzt.
03 / UNTER DER OBERFLÄCHE
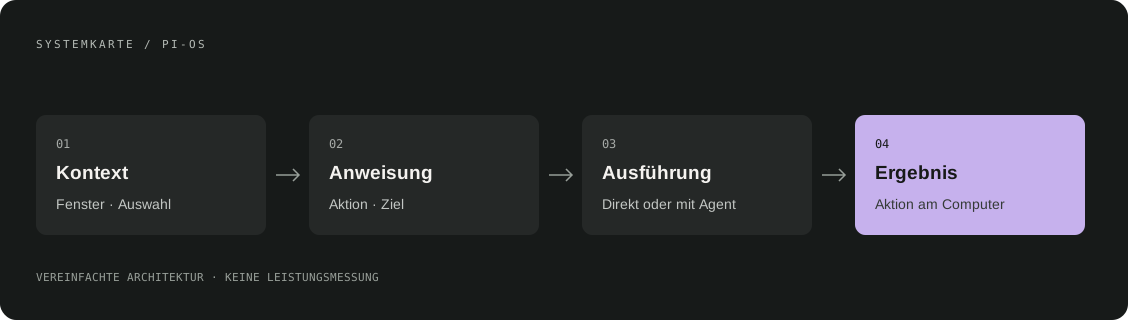
Von der Absicht zur Aktion.
So soll die Interaktion laufen: Kontext erkennen, Anweisung verstehen und direkt oder mit dem Agenten ausführen. Mein Mac-Port baut auf PriNovas Windows-Projekt auf, mit Swift/AppKit und einem lokalen Node-Dienst für pi. Modellanfragen können einen externen Provider nutzen, Desktop-Aktionen bleiben freigabepflichtig.
Oberfläche
Swift / AppKit
Agent-Runtime
Node.js / pi SDK
Plattform
macOS 14+
Host-Protokoll
Lokal über HTTP / JSON
Lizenz
MIT
Herkunft
Mac-Port von PriNova/pi-os
04 / GENAUER HINGESCHAUT
Demo und installierter Build.
BILD ANKLICKEN ZUM VERGRÖSSERN ↗
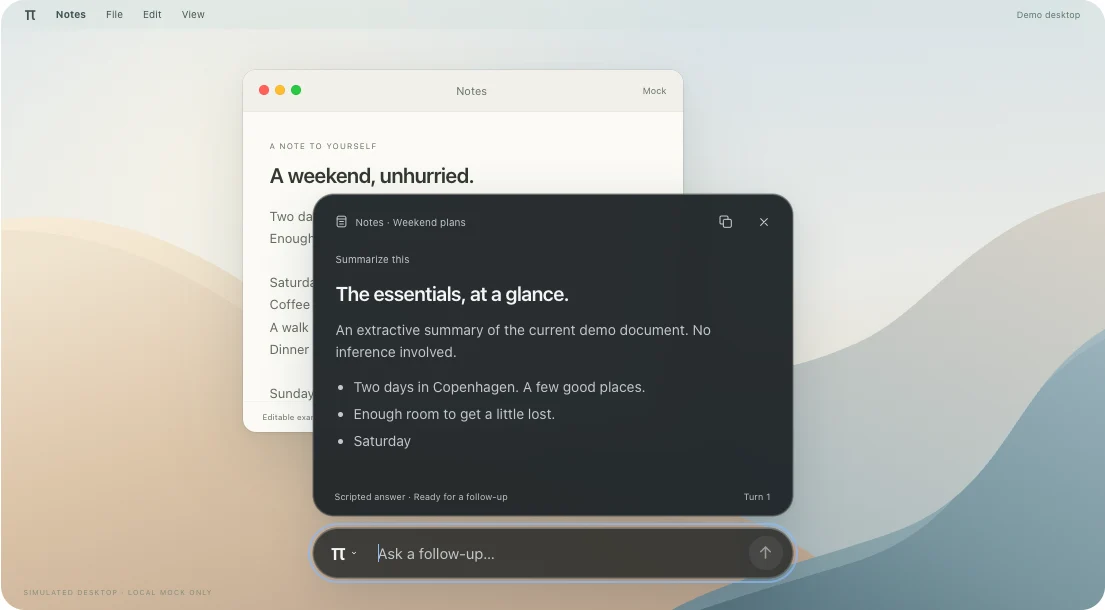
Geskriptete Website-Demo
Eine Notiz, die Befehlsleiste und der Antwort-Reader in der Website-Demo. Die gezeigte Antwort ist geskriptet und stammt nicht aus einem Modell.
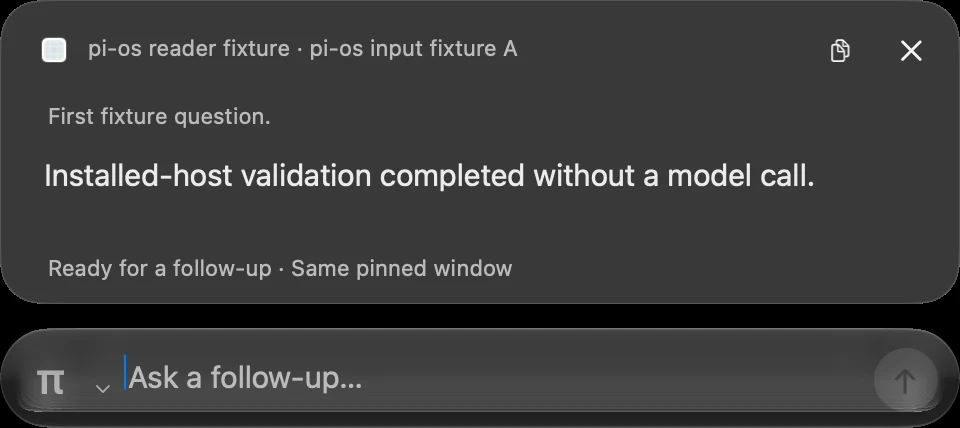
Installierte Mac-Preview
Validierungsaufnahme des installierten Build 12. Der native Host hat Antwort und Folgefragen-Leiste ohne Modellaufruf gerendert.
05 / ANSEHEN
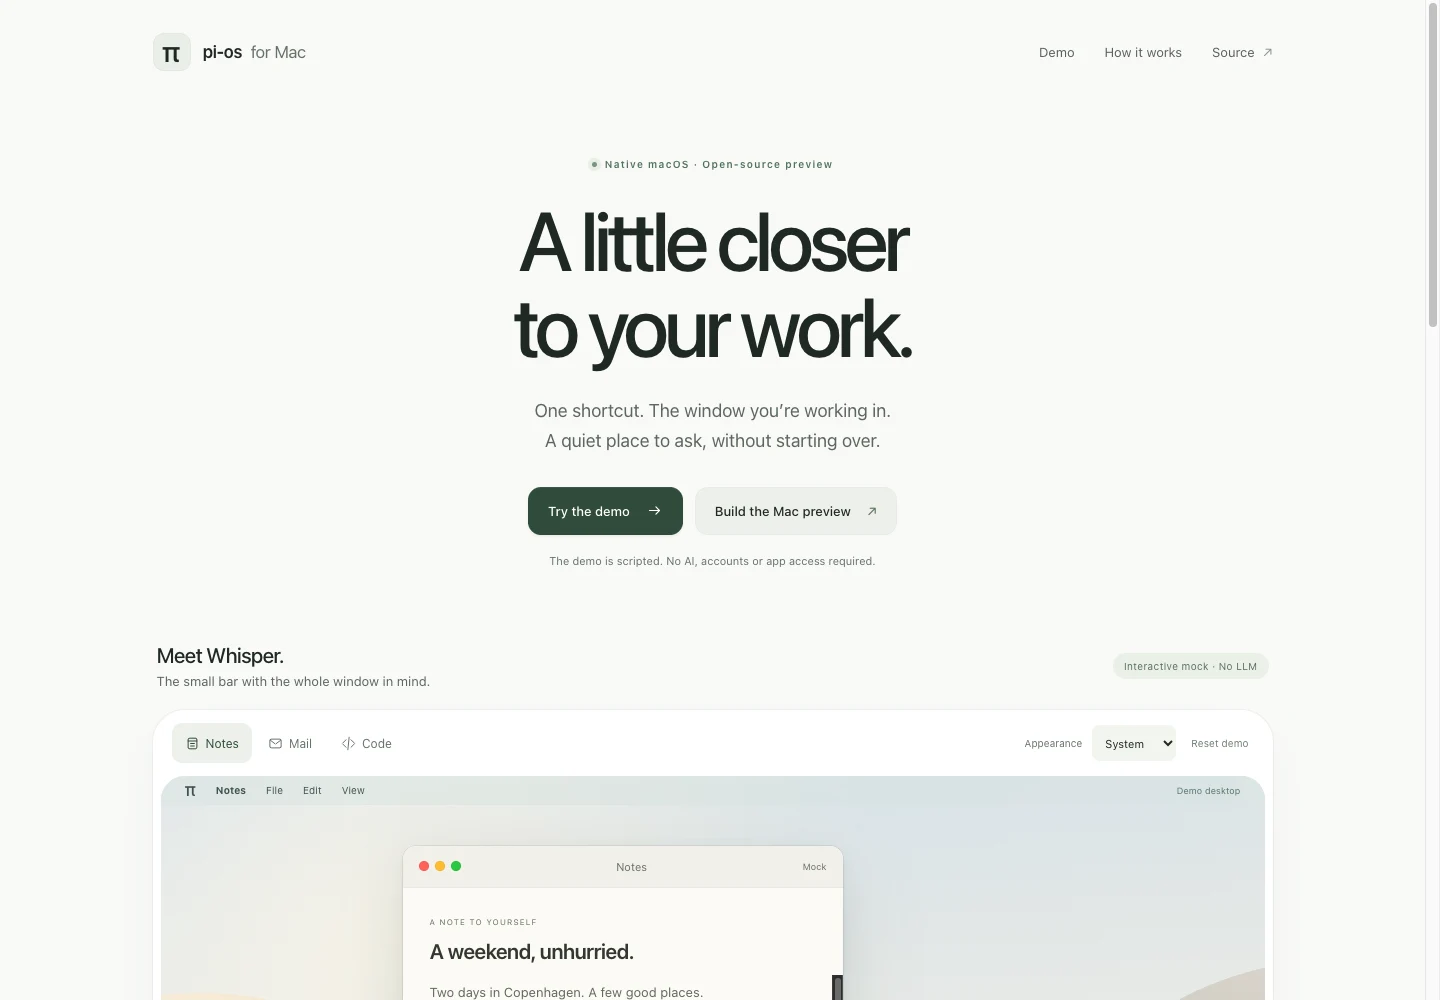
Die geskriptete Demo.
Die Projekt-Website zeigt eine geskriptete Desktop-Demo. Sie ruft kein Modell auf und greift nicht auf deinen Rechner zu.